AI 训练数据的版权风险:4 类来源 + 3 个海外判例 + 国内合规建议
"爬了 30 万张图给模型训练,会被告吗?"用 ChatGPT 改写的文章属于谁?"用户上传到 UGC 平台的内容,能直接喂给模型吗?"第三方开源数据集,许可范围到哪?
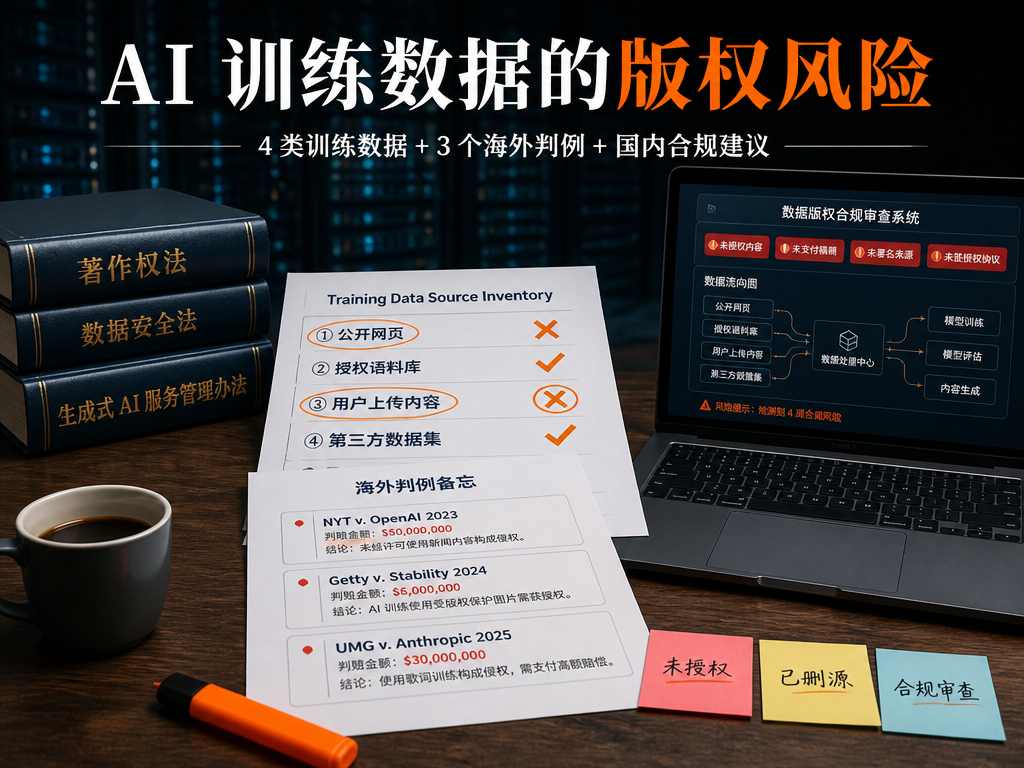
2026 年生成式 AI 全面落地,训练数据合规成了最绕不开的话题。这篇用 4 类数据来源 + 3 个海外判例,帮你把"AI 训练数据的版权红线"一次讲透。
一、为什么训练数据合规问题突然变热?
2023 年以来,3 类事件把 AI 训练数据的版权问题推上风口浪尖:
- 📌 2023.12 《纽约时报》起诉 OpenAI——百万篇文章被未经授权用于训练
- 📌 2024.05 Getty Images 起诉 Stability AI——1200 万张图片含版权水印被爬取
- 📌 2025.06 环球音乐起诉 Anthropic——歌词文本被无授权使用
💡 核心争议:AI 训练数据到底算"合理使用"(fair use)还是"未经授权的复制"?各国法院给出了完全不同的答案。
二、4 类 AI 训练数据:风险地图
不同来源的数据,风险等级差异巨大。先看清你用的是哪一类:
🌐 来源 1:公开网页数据(高风险)
通过爬虫抓取公开可访问的网页、图片、视频。
典型来源:
- Common Crawl 抓取的全网数据
- 搜索引擎索引的公开页面
- 社交媒体的"公开"内容
风险点:
- ⚠️ "公开可见" ≠ "可商用训练"——能看到不等于能用
- ⚠️ 大量受版权保护的作品被混入
- ⚠️ 来源不可追溯,无法逐条授权
🚨 典型案例:
某创业公司用 Common Crawl 抓了 10 亿网页训练行业大模型,未做任何清洗和过滤。2024 年被 3 家媒体联合起诉,最终庭外和解,赔偿金额保密,并被要求 下架全部模型。
📚 来源 2:授权语料库(中风险)
通过商业授权获取的、已经过版权方授权的数据集。
典型来源:
- 路透社、Bloomberg 等授权新闻数据
- Shutterstock、Getty 等图片授权库
- 专业出版社授权的电子书/论文库
风险点:
- ✅ 基础合规有保障——拿到授权即可商用
- ⚠️ 授权范围需逐条核对(训练权 ≠ 商用权 ≠ 微调权)
- ⚠️ 授权期限到期需续签,否则会失去合法性
- ⚠️ 授权地域是否覆盖你的目标市场
📖 行业实操:头部大厂训练语料的授权成本占总预算的 15%-30%。不签授权直接爬 = 拿整个公司做赌注。
👤 来源 3:用户上传内容(高风险)
用户协议中允许使用 UGC(用户生成内容)训练 AI。
典型来源:
- UGC 平台用户上传的图文/视频
- 用户授权的对话记录
- 用户上传的代码、个人笔记
风险点:
- ⚠️ 用户协议条款是否清晰——是否明确说明"用于 AI 训练"
- ⚠️ 用户是否实际知情——长篇用户协议通常无效
- ⚠️ 未成年人上传内容——需取得监护人同意
- ⚠️ 敏感个人信息——违反《个人信息保护法》
🚨 真实案例:
某 AI 对话 App 在用户协议第 27 条夹带"您上传的内容可用于模型训练",未做显著提示。2024 年被监管处罚,下架 3 个月,被认定为"违规收集使用个人信息"。
🗂️ 来源 4:第三方数据集(低-中风险)
从 Hugging Face、GitHub 等平台下载的开源/公开数据集。
典型来源:
- 开源数据集(The Pile、C4、LAION)
- GitHub 开源项目代码
- 学术研究发布的数据集
风险点:
- ✅ 开源协议清楚(MIT/Apache/GPL)——风险最低
- ⚠️ 协议传染性——GPL 数据训练的模型可能也要开源
- ⚠️ 数据集本身的版权——开源 ≠ 无版权
- ⚠️ 数据集中混入侵权内容(LAION-5B 含 CSAM 事件)
三、3 个海外判例:法院怎么判?
📌 判例 1:纽约时报 v. OpenAI / Microsoft(2023.12 美国)
案情:纽约时报起诉 OpenAI 和 Microsoft 未经授权使用其数百万篇文章训练 GPT 模型,要求销毁模型 + 数十亿美元赔偿。
法院进展(截至 2026.08):
- ✅ 案件进入实质审理,未被驳回
- ✅ 法院认定"合理使用"不是必然抗辩,需逐案审查
- ⚠️ 双方在 2025 年进入和解谈判,最终结果未公开
关键点:此案是 AI 训练数据合规的分水岭——媒体行业 vs AI 行业的对峙,将决定整个行业的授权模式。
📌 判例 2:Getty Images v. Stability AI(2024.05 英国)
案情:Getty Images 起诉 Stability AI 未经授权使用其 1200 万张带版权水印的图片训练 Stable Diffusion 模型。
法院判决(2025.11 英国高等法院):
- ✅ Stability AI 部分败诉——在英国市场侵犯版权
- ✅ 要求 Stability AI 停止在英国销售侵权模型
- ⚠️ 赔偿金额:未定,媒体披露可能达数千万英镑
关键点:带水印的图片被用于训练 = 铁证。这一判决让"我不知道来源"的抗辩彻底失效。
📌 判例 3:环球音乐等 v. Anthropic(2025.06 美国)
案情:环球音乐、词曲版权人等联合起诉 Anthropic,其 Claude 模型使用了大量受版权保护的歌词文本进行训练,且能逐字复现知名歌词。
法院判决:
- ✅ 达成和解协议(2025.12)
- ✅ Anthropic 同意 建立版权方补偿机制
- ⚠️ 和解金额未完全披露,媒体估算超 10 亿美元
关键点:模型能复现原内容 = 训练数据侵权的直接证据。这一逻辑已成为后续诉讼的通用范式。
📊 司法趋势:逐案审查 > 一刀切。训练数据可追溯 + 授权清晰 + 不会复现原内容 三件事全做到,才有"合理使用"的底气。
四、国内合规:6 步落地建议
相比欧美,国内监管对 AI 训练数据 已经形成 "双线合规"——版权 + 数据安全。具体怎么落地:
步骤 1:数据来源分类登记
→ 建立 训练数据来源台账,逐条记录:来源 / 授权时间 / 授权范围 / 授权方
→ 公开网页数据 → 单独标记"未经授权"风险
步骤 2:核心数据走授权
→ 关键训练语料(新闻/专业内容/作品集)必须走商业授权
→ 合同明确:训练权 + 微调权 + 商用权 + 衍生作品权 + 地域 + 期限
步骤 3:用户协议显著告知
→ 用户上传内容用于训练 → 协议中独立条款 + 显著提示
→ 注册时弹出二次确认 → 留存用户同意记录
步骤 4:去重 + 过滤
→ 训练前:去重(同一作品不重复训练)+ 过滤(删除已知版权方黑名单)
→ 训练后:评估模型复现能力,避免逐字输出原内容
步骤 5:保留合规证据链
→ 授权文件 + 来源台账 + 清洗记录 + 模型卡 (model card) 全部归档
→ 出事时能拿出证据 = 抗辩的底气
步骤 6:定期合规复盘
→ 每 6 个月 复盘训练数据来源 + 授权到期 + 监管变化
→ 监管政策和判例在持续变化,不能"一劳永逸"
五、5 个"避坑"建议
❌ 坑 1:爬取"公开可见"的内容 = 一定安全
真相:公开可见 ≠ 可商用 ≠ 可训练。Getty v. Stability 已经给出答案。
❌ 坑 2:用了开源数据集 = 一定不侵权
真相:开源数据集本身可能含未授权内容(如 LAION-5B 事件)。用之前要审查数据集本身的来源。
❌ 坑 3:用户协议里写了 = 用户同意
真相:长篇协议中夹带关键条款,法院会判定无效。需 显著告知 + 单独同意。
❌ 坑 4:模型不输出原内容 = 不侵权
真相:未经授权复制用于训练本身就是侵权行为,不依赖最终输出形态。
❌ 坑 5:训练在国外 = 不受中国法律约束
真相:长臂管辖 + 数据出境双重监管,中国用户使用 = 中国法律适用。
🎯 一句话总结:训练数据来源清晰 + 授权完备 + 用户告知到位 + 模型不逐字复现,这 4 件事是 AI 训练数据合规的底线。
六、AI 训练数据合规有疑问?让专业服务帮你拆解
🛡️ AI 训练数据合规 + 版权登记代办,2 个工具能帮你:
📋 数据合规审查 + 训练语料授权代办
专业知产 + 数据合规团队,训练数据来源台账 / 授权合同 / 用户告知流程全流程代办。风险评估 + 合规整改 + 证据链归档,从源头帮你把版权风险关进笼子。
📱 松鼠云知产小程序
知产行业专属小程序,训练语料授权 / 软著登记 / 商标注册 / 版权登记全流程线上办理。从合规审查到证书到手最快几个工作日,打开微信搜「松鼠云知产」直接体验。
📌 以上服务均为深圳市创意云网络科技有限公司(一站式企业服务,含知产服务与软件开发)提供 | 联系电话 15796418895
有问题,来知产服务;想避坑,先看知产服务。